Big Data representa um dos avanços mais significativos na forma como a sociedade contemporânea gera, processa e interpreta a informação digital. Diariamente, exabytes de registros são criados por intermédio de interações em redes sociais, transações financeiras, leituras de sensores inteligentes de Internet das Coisas (IoT), registros médicos e navegação na web. O imenso volume e a velocidade com que esses dados são produzidos superam totalmente a capacidade de processamento dos sistemas de bancos de dados tradicionais, exigindo arquiteturas tecnológicas inovadoras capazes de transformar dados brutos em conhecimento valioso.
Compreender esse fenômeno vai muito além de mensurar grandes quantidades de bytes armazenados em servidores. Trata-se de uma mudança estrutural na tomada de decisões estratégicas em empresas, órgãos governamentais e instituições de pesquisa. Quando organizações conseguem capturar e analisar fluxos massivos de informações em tempo real, torna-se possível antecipar tendências de consumo, otimizar operações logísticas complexas, desenvolver tratamentos médicos personalizados e prevenir fraudes financeiras com precisão inédita.
Ao longo deste artigo, examinaremos em profundidade o conceito essencial da ciência de dados massiva, os pilares técnicos fundamentais que sustentam essa infraestrutura, suas aplicações mais impactantes nos setores produtivos e os desafios impostos pela segurança e pela privacidade das informações.
Big Data: O Conceito e a Transformação Digital
Em termos conceituais, o termo descreve conjuntos de dados tão grandes, heterogêneos e complexos que ferramentas convencionais de gerenciamento de dados relacionais — como planilhas eletrônicas e bancos de dados SQL padronizados — não conseguem capturar, armazenar ou analisar em um tempo hábil. A transição da computação clássica para a era dos dados massivos ocorreu devido à digitalização acelerada da sociedade e ao barateamento do armazenamento em nuvem.
Historicamente, a maior parte dos dados empresariais era altamente estruturada, organizada em colunas e linhas claramente definidas. Contudo, atualmente estima-se que mais de 80% de todas as novas informações geradas sejam não estruturadas ou semiestruturadas. Isso inclui arquivos de áudio, vídeos, imagens de satélite, registros de log de servidores, mensagens de texto e dados de geolocalização. A análise desses formatos exige novos algoritmos de aprendizado de máquina e sistemas de inteligência artificial.
No Brasil, a consolidação de políticas de desenvolvimento científico e inovação tecnológica impulsiona o uso da computação de alto desempenho em setores vitais para a economia. Para obter detalhes sobre diretrizes públicas e fomento em infraestrutura tecnológica no país, é possível consultar o portal oficial do Ministério da Ciência, Tecnologia e Inovações, que acompanha o avanço do ecossistema digital brasileiro.
Os Pilares Fundamentais do Processamento Massivo de Informações
Para categorizar os requisitos técnicos de ambientes computacionais de alto desempenho, a literatura especializada estabeleceu o modelo dos Vs. Inicialmente proposto com três dimensões principais, o conceito evoluiu para incorporar aspectos qualitativos e econômicos essenciais para os negócios.
Volume e Velocidade: A Escala do Ecossistema
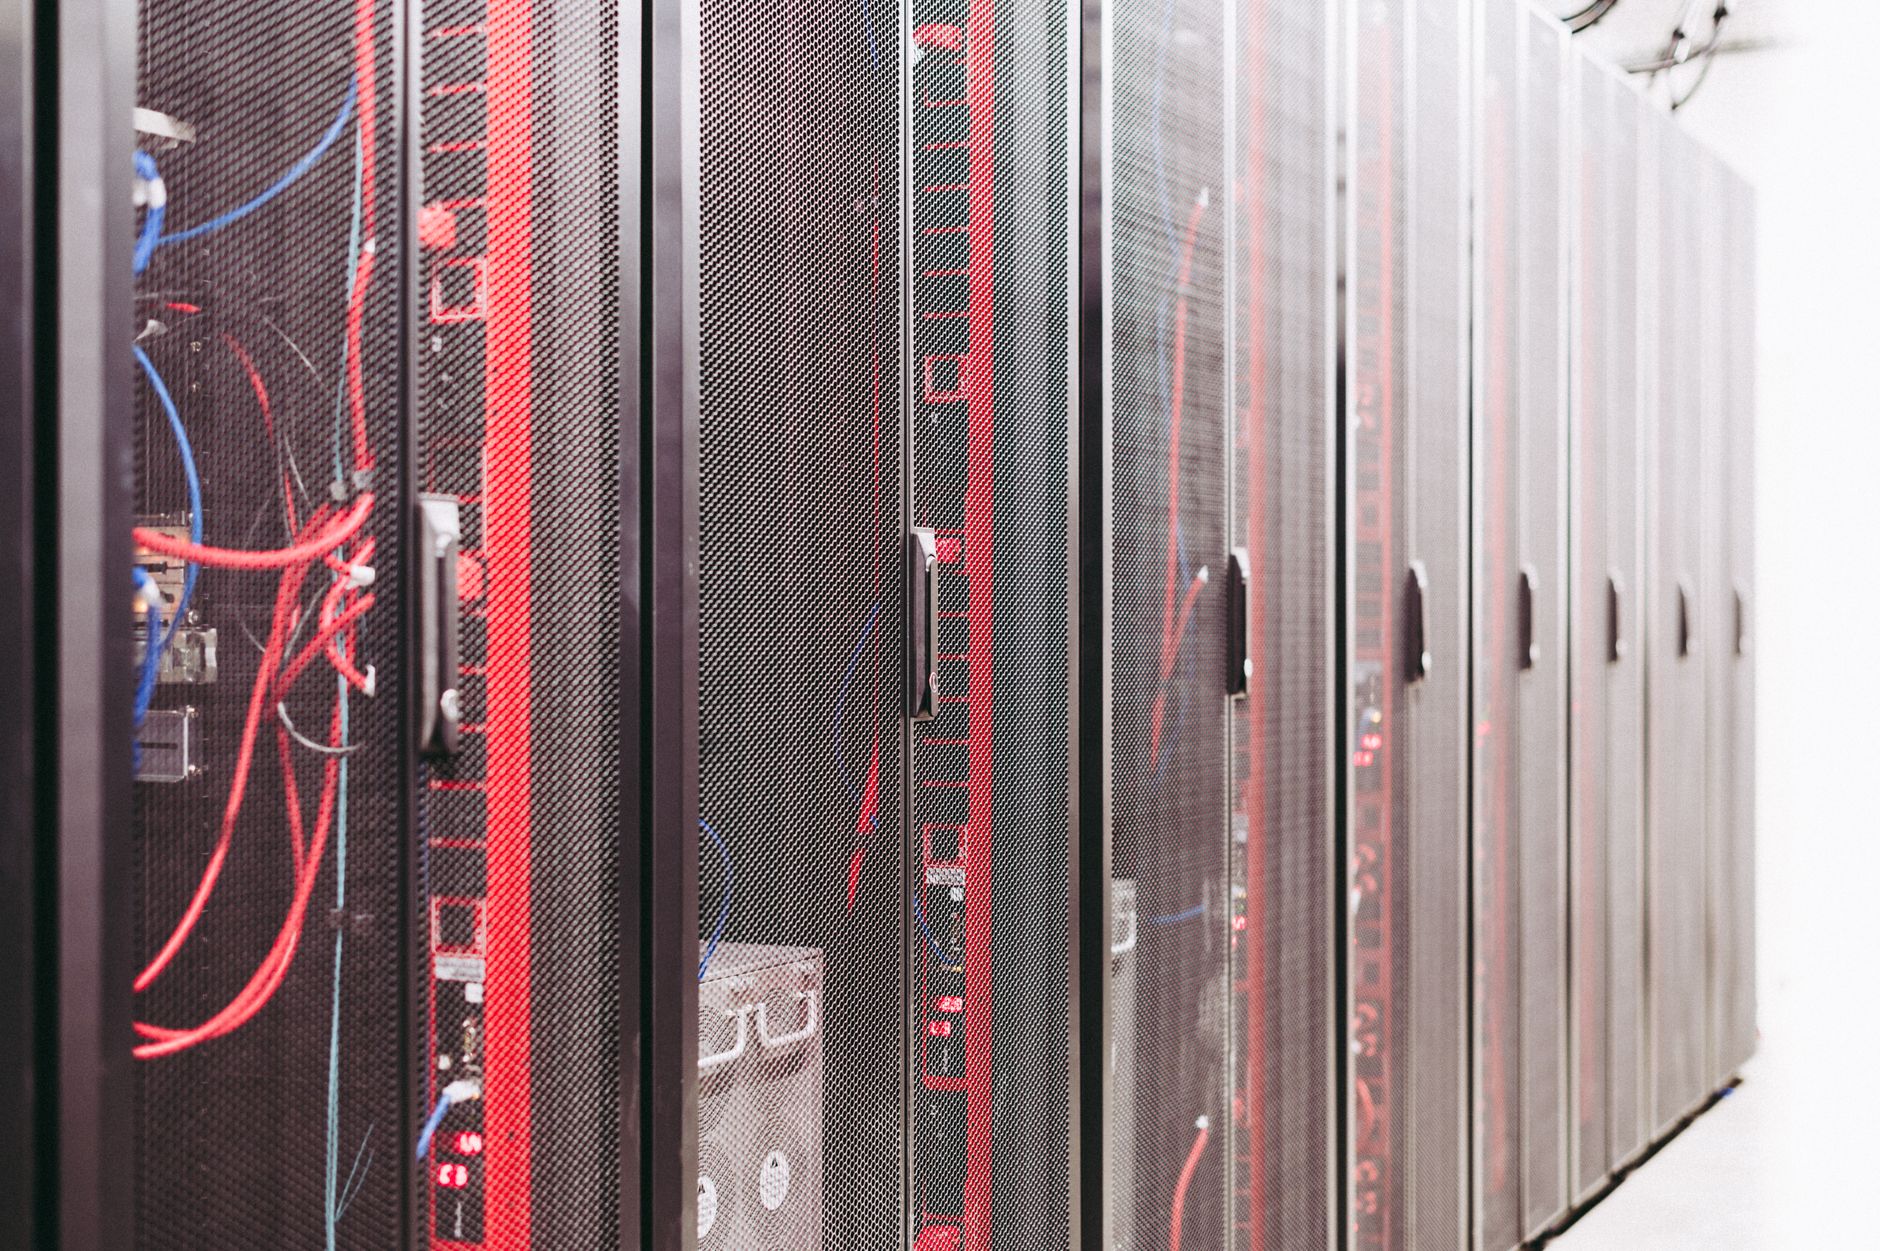
O Volume refere-se à quantidade astronômica de dados gerados a cada segundo. Falamos em escalas de terabytes, petabytes e exabytes. Armazenar essa imensidão de registros requer arquiteturas distribuídas, nas quais a capacidade de armazenamento é particionada em centenas ou milhares de servidores interconectados operando em paralelo.
A Velocidade diz respeito ao ritmo alucinante em que as informações são transmitidas e necessitam ser processadas. Em cenários como o mercado financeiro ou o monitoramento de sistemas críticos, o processamento em tempo real (streaming de dados) é indispensável. Atrasos de milissegundos podem significar prejuízos milionários ou falhas operacionais graves.
Variedade, Veracidade e Valor: Qualidade e Diversidade
A Variedade abraça a diversidade de formatos de dados. Em uma única plataforma, é necessário integrar dados estruturados de um banco SQL, textos de redes sociais, imagens enviadas por usuários e telemetria de sensores industriais. Integrar fontes heterogêneas é um dos maiores desafios de engenharia de software.
A Veracidade aborda a confiabilidade da informação. Em meio a volumes colossais, há um nível elevado de ruído, dados corrompidos ou inconsistentes. A implementação estratégica de Big Data exige etapas rigorosas de limpeza, validação e governança para garantir que as conclusões extraídas sejam fundamentadas em fatos precisos.
Por fim, o Valor é o propósito final do ecossistema. Não há benefício corporativo ou acadêmico em acumular petabytes de dados se eles não puderem ser convertidos em inteligência acionável, tomada de decisão fundamentada e geração de eficiência ou receita para a organização.
Como Funciona o Ciclo de Vida dos Dados em Larga Escala
O processamento analítico de grandes volumes exige um pipeline estruturado que transforma registros brutos em relatórios, painéis de inteligência de negócios (BI) e modelos preditivos. O ciclo de vida compreende fases interdependentes e altamente automatizadas.
Coleta e Ingestão de Informações
A etapa inicial é a ingestão, na qual dados de origens variadas são capturados e transferidos para o repositório central. Esse processo pode ocorrer em lotes (batch processing), em horários agendados, ou de forma contínua em tempo real (stream processing), utilizando ferramentas especializadas de mensageria para evitar gargalos de transferência.
Armazenamento Distribuído e Arquiteturas Modernas
Uma vez ingeridos, os dados precisam ser armazenados de maneira escalável. As arquiteturas modernas empregam frequentemente a abordagem de Data Lakes (lagos de dados), onde os arquivos brutos são guardados em seu formato nativo. Diferente dos Data Warehouses tradicionais, que exigem estruturação prévia antes da gravação, os Data Lakes oferecem flexibilidade para análises futuras de diversos tipos.
Processamento, Análise e Visualização
Com as informações armazenadas, sistemas de computação distribuída executam consultas complexas e algoritmos analíticos. Essa etapa transforma os dados em indicadores de desempenho (KPIs), insights de comportamento de consumidores e projeções estatísticas. Os resultados são então apresentados em dashboards interativos acessíveis aos gestores.
Principais Aplicações do Setor no Cotidiano Empresarial
As tecnologias analíticas de alto volume deixaram de ser exclusividade de gigantes da tecnologia e hoje moldam a operação diária de diversos setores da economia global.
Setor Financeiro e Prevenção a Fraudes
Bancos e operadoras de cartão de crédito utilizam análises preditivas em milissegundos para verificar transações suspeitas. Ao comparar o histórico de compras de um cliente, sua localização geográfica habitual e o padrão do estabelecimento com o comportamento em tempo real, ecossistemas de Big Data garantem a integridade das operações e bloqueiam tentativas de fraude antes de sua conclusão.
Saúde, Medicina de Precisão e Epidemiologia
Na área da saúde, o cruzamento de dados genéticos, prontuários eletrônicos e hábitos de vida permite o desenvolvimento da medicina de precisão, onde tratamentos para doenças complexas são customizados para o perfil de cada paciente. Além disso, órgãos de saúde pública analisam dados de buscas e registros médicos para rastrear a proliferação de surtos epidemiológicos de forma precoce.
Varejo, Logística e Personalização de Experiências
Grandes redes varejistas e plataformas de e-commerce empregam sistemas de recomendação para oferecer produtos personalizados com base no comportamento de navegação do usuário. Na logística, a análise de dados meteorológicos, de tráfego urbano e de demandas regionais otimiza rotas de entrega, reduzindo significativamente custos com combustível e prazos de envio.
Desafios Contemporâneos e Governança de Informações
Apesar dos inegáveis benefícios, a gestão massiva de dados traz desafios éticos e operacionais profundos. O principal deles refere-se à privacidade de dados pessoais e à conformidade com legislações rígidas, como a Lei Geral de Proteção de Dados (LGPD) no Brasil e a GDPR na União Europeia. As empresas precisam garantir o consentimento dos titulares e a segurança cibernética das informações coletadas.
Outro ponto crítico é a segurança contra vazamentos de dados. Armazenar repositórios centralizados contendo bilhões de registros sensíveis transforma as empresas em alvos altamente atrativos para ataques de cibercriminosos. Portanto, plataformas modernas de Big Data incorporam rigorosos protocolos de criptografia, controle de acesso e auditoria contínua.
Além disso, existe a questão do viés algorítmico. Quando modelos de aprendizado de máquina são treinados com conjuntos de dados históricos que contêm distorções ou preconceitos implícitos, esses modelos podem reproduzir ou amplificar discriminações em processos de concessão de crédito, recrutamento de pessoal ou análise de risco.
O Futuro da Inteligência Analítica
O futuro do ecossistema de dados está intrinsecamente conectado ao avanço da inteligência artificial generativa e da computação em névoa (fog computing). A necessidade de processar dados diretamente na borda (edge computing) — ou seja, no próprio dispositivo ou sensor que coleta a informação — reduzirá a dependência do envio constante de dados para data centers centrais, diminuindo a latência e o consumo de banda de rede.
À medida que a quantidade de dados gerados pela humanidade continua a crescer em ritmo exponencial, as organizações que desenvolverem capacidade sólida de governança, infraestrutura escalável e cultura orientada a dados estarão melhor posicionadas para liderar a inovação em seus respectivos mercados.
Perguntas frequentes
Qual é a diferença entre dados estruturados e não estruturados?
Dados estruturados são organizados em formatos definidos e rígidos, como tabelas e colunas de bancos de dados relacionais. Dados não estruturados não possuem estrutura pré-definida, incluindo textos livres, imagens, áudios, vídeos e registros de redes sociais.
Quais são os 5 Vs mais citados na ciência de dados?
Os 5 Vs do Big Data são Volume (quantidade de dados), Velocidade (ritmo de geração e processamento), Variedade (diversidade de formatos), Veracidade (confiabilidade da informação) e Valor (utilidade prática para o negócio).
Como a LGPD afeta a análise de grandes volumes de dados no Brasil?
A LGPD exige que a coleta e o tratamento de dados pessoais ocorram com base legal explícita, transparência e consentimento, além de garantir aos titulares o direito de acesso, correção e exclusão de seus dados.
Quais são as ferramentas mais utilizadas para processamento de Big Data?
Entre as ferramentas mais populares estão frameworks de processamento distribuído como Apache Hadoop e Apache Spark, bancos de dados NoSQL como MongoDB e Cassandra, e serviços de nuvem como AWS, Google Cloud e Microsoft Azure.
Qual é a diferença entre um Data Lake e um Data Warehouse?
Um Data Warehouse armazena dados purificados, estruturados e otimizados para consultas analíticas específicas. Um Data Lake armazena grandes volumes de dados em seu formato bruto (estruturado, semiestruturado ou não estruturado) para uso futuro flexível.
Como a Inteligência Artificial se conecta ao Big Data?
O Big Data fornece o imenso volume de dados necessários para treinar algoritmos de aprendizado de máquina (Machine Learning) e inteligência artificial, permitindo identificar padrões complexos e fazer previsões com alta precisão.
Quais habilidades são fundamentais para um profissional de ciência de dados?
Um profissional da área precisa dominar linguagens de programação como Python e R, conhecimentos estatísticos e matemáticos, bancos de dados SQL e NoSQL, visão de negócios e técnicas de visualização de dados.
Pequenas empresas podem se beneficiar da análise massiva de dados?
Sim. Com o surgimento de plataformas analíticas em nuvem no modelo SaaS (Software as a Service), pequenas e médias empresas conseguem acessar inteligência de dados pagando apenas pelo uso, sem a necessidade de investir em infraestrutura própria pesada.